1 从逐个比较到共享前缀
维护一批字符串,支持三种操作:插入一个字符串、判断一个完整字符串是否出现过、统计有多少字符串以某个前缀开头。本文先限定字符为小写字母 a 到 z,重复插入按次数统计。
最直接的做法是把字符串放进数组。询问前缀 app 时,就把它与每个字符串的开头比较。若共有
观察 app、apple、apply:它们开头的三个字符完全相同。如果把这段公共前缀只存一份,查找时走到 app,就已经同时找到了这三个字符串的共同入口。
把字符串的公共前缀合并成树上的同一段路径;插入和查询都从根出发,每读一个字符,就沿对应的边走一步。
2 一条路径表示一个前缀
Trie 是一棵有根树。每条边代表一个字符,同一节点的出边字符互不相同;从根到某个节点的路径上,字符依次拼接成一个前缀。根表示空串。
节点表示前缀,边表示字符。 节点编号只是程序中访问节点的位置,同一个字符可以出现在不同的边上。
把 app、apple、apply、apt、bat 插入后,得到下面这棵树。加粗的三条边表示公共前缀 app,双圈表示有完整字符串在这里结束。
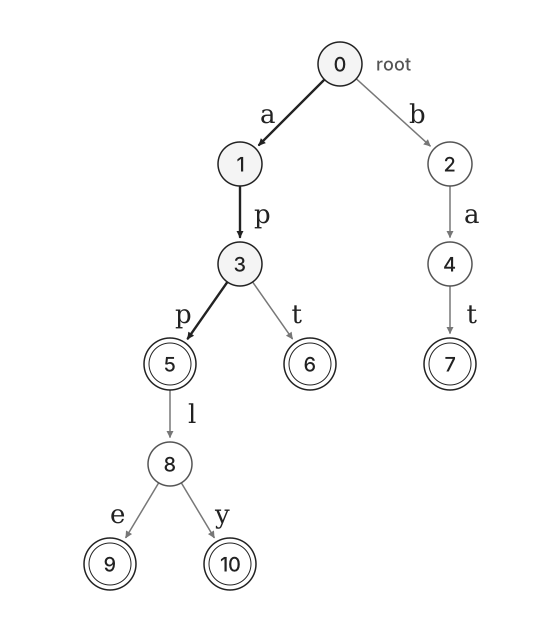
沿根到 app。它本身是一个完整字符串,但还能沿 l 继续到 appl,再沿 e 或 y 到达 apple、apply。apt 在前缀 ap 后改走 t;bat 则从根开始走另一条分支。图中的编号用于区分节点,不要求与插入时的创建顺序一致。
只插入 apple 时,a、ap、app 的路径都会存在,但它们没有被作为完整字符串插入过。因此,必须另外记录「字符串在这里结束」。
3 节点维护什么
每个节点保存三类信息:
| 字段 | 含义 | 用途 |
|---|---|---|
ch[c] |
沿字符 c 到达的孩子节点编号 |
沿字符查找下一步 |
pass |
拥有当前前缀的字符串数量,按插入次数统计 | 前缀计数 |
end |
恰好在当前节点结束的字符串数量 | 完整字符串查询、重复次数统计 |
对于图中的五个字符串,部分节点的数据如下。表中的「前缀」由根到节点的路径确定,程序不需要把它再存一份。
| 节点 | 前缀 | pass |
end |
|---|---|---|---|
| 0 | 空串 | 5 | 0 |
| 1 | a |
4 | 0 |
| 3 | ap |
4 | 0 |
| 5 | app |
3 | 1 |
| 8 | appl |
2 | 0 |
| 9 | apple |
1 | 1 |
| 6 | apt |
1 | 1 |
| 7 | bat |
1 | 1 |
pass 和 end 回答的是两个不同的问题:有多少字符串以它开头,以及有多少字符串恰好等于它。例如 appl 的 pass = 2,但 end = 0。
如果再插入一次 app,只需复用原路径:根、a、ap、app 的 pass 各加一,app 的 end 从
4 三种基本操作
4.1 插入字符串
以插入 apt 为例:
- 从根出发,根的
pass加一,表示又插入了一个字符串。 - 读入
a。若没有对应的边,就新建孩子;走过去,该节点的pass加一。 - 对
p、t重复同样的操作。已有路径直接复用,缺少哪一段就创建哪一段。 - 所有字符处理完毕,在当前节点令
end加一。
根表示空串,第一条边对应字符串的第一个字符。若沿用上一次操作结束时的位置,就把新字符串接在了旧前缀后面。
4.2 查询完整字符串
从根出发,依次沿查询串的字符走。如果中途缺少某条边,立即返回不存在;如果走完全部字符,再检查末尾节点的 end > 0。
例如查询 ap:虽然能从根走到 end = 0,所以答案是不存在。查询 app 则在 end = 1,答案是存在。
4.3 查询前缀数量
仍然从根出发,沿前缀走。如果中途断路,返回 pass。
例如查询前缀 app,走到
5 为什么这些操作正确
对任意节点 pass[u] 等于以 end[u] 等于恰好等于
初始时只有根,所有计数为 pass 加一;同时只在完整字符串对应的节点给 end 加一。其他节点不变,所以不变量始终成立。
查询时,相同字符从同一节点出发只能选择同一条边,因此一个前缀最多对应一个节点。路径不存在,说明没有任何插入的字符串具有这个前缀;路径存在,则根据不变量,检查 end 或读取 pass 就能得到所需答案。
6 代码模板
C++ 使用固定大小的孩子数组,字符范围为 a 到 z。
Python 使用字典存储实际存在的字符边,并把 pass 命名为 pass_count,因为 pass 是 Python 关键字。两个版本使用相同接口:insert、contains、count_prefix。
#include <array>
#include <string>
#include <vector>

// 小写字母 a-z;0 号节点为根,孩子编号 0 表示不存在。
// 重复插入按次数统计。pass 统计前缀,end 统计完整字符串。
struct Trie {
    struct Node {
        std::array<int, 26> ch{};
        int pass = 0;
        int end = 0;
    };

    std::vector<Node> tree{1};

    void insert(const std::string &s) {
        int u = 0;
        ++tree[u].pass;
        for (char c : s) {
            int x = c - 'a';
            int v = tree[u].ch[x];
            if (v == 0) {
                v = static_cast<int>(tree.size());
                tree[u].ch[x] = v;
                tree.emplace_back();
            }
            u = v;
            ++tree[u].pass;
        }
        ++tree[u].end;
    }

    // 返回字符串对应节点;路径不存在时返回 -1。
    int find(const std::string &s) const {
        int u = 0;
        for (char c : s) {
            int v = tree[u].ch[c - 'a'];
            if (v == 0) return -1;
            u = v;
        }
        return u;
    }

    bool contains(const std::string &s) const {
        int u = find(s);
        return u != -1 && tree[u].end > 0;
    }

    int count_prefix(const std::string &prefix) const {
        int u = find(prefix);
        return u == -1 ? 0 : tree[u].pass;
    }
};
class Trie:
    """节点 0 为根;字典只保存实际存在的字符边。"""

    def __init__(self) -> None:
        self.ch: list[dict[str, int]] = [{}]
        self.pass_count: list[int] = [0]
        self.end: list[int] = [0]

    def insert(self, s: str) -> None:
        u = 0
        self.pass_count[u] += 1
        for c in s:
            v = self.ch[u].get(c)
            if v is None:
                v = len(self.ch)
                self.ch[u][c] = v
                self.ch.append({})
                self.pass_count.append(0)
                self.end.append(0)
            u = v
            self.pass_count[u] += 1
        self.end[u] += 1

    def find(self, s: str) -> int:
        """返回字符串对应节点;路径不存在时返回 -1。"""
        u = 0
        for c in s:
            v = self.ch[u].get(c)
            if v is None:
                return -1
            u = v
        return u

    def contains(self, s: str) -> bool:
        u = self.find(s)
        return u != -1 and self.end[u] > 0

    def count_prefix(self, prefix: str) -> int:
        u = self.find(prefix)
        return 0 if u == -1 else self.pass_count[u]
vector 新增节点时可能扩容,使原有元素的引用失效。不要把 tree[u].ch[c] 的引用保留到 emplace_back() 之后再使用。模板先保存孩子编号,再创建节点,随后按编号访问。
模板也能处理空串:根的 pass 是插入总次数,根的 end 是空串插入次数。下面的完整程序按空白分隔输入,所以只读入非空字符串。
7 完整程序与样例
输入第一行是
1 s:判断完整字符串s是否出现,输出Yes或No。2 s:统计有多少字符串以s为前缀,输出数量。
#include <array>
#include <string>
#include <vector>

// 小写字母 a-z;0 号节点为根,孩子编号 0 表示不存在。
// 重复插入按次数统计。pass 统计前缀,end 统计完整字符串。
struct Trie {
    struct Node {
        std::array<int, 26> ch{};
        int pass = 0;
        int end = 0;
    };

    std::vector<Node> tree{1};

    void insert(const std::string &s) {
        int u = 0;
        ++tree[u].pass;
        for (char c : s) {
            int x = c - 'a';
            int v = tree[u].ch[x];
            if (v == 0) {
                v = static_cast<int>(tree.size());
                tree[u].ch[x] = v;
                tree.emplace_back();
            }
            u = v;
            ++tree[u].pass;
        }
        ++tree[u].end;
    }

    // 返回字符串对应节点;路径不存在时返回 -1。
    int find(const std::string &s) const {
        int u = 0;
        for (char c : s) {
            int v = tree[u].ch[c - 'a'];
            if (v == 0) return -1;
            u = v;
        }
        return u;
    }

    bool contains(const std::string &s) const {
        int u = find(s);
        return u != -1 && tree[u].end > 0;
    }

    int count_prefix(const std::string &prefix) const {
        int u = find(prefix);
        return u == -1 ? 0 : tree[u].pass;
    }
};

#include <iostream>

int main() {
    std::ios::sync_with_stdio(false);
    std::cin.tie(nullptr);

    int n, q;
    if (!(std::cin >> n >> q)) return 0;
    Trie trie;
    for (int i = 0; i < n; ++i) {
        std::string s;
        std::cin >> s;
        trie.insert(s);
    }
    while (q--) {
        int op;
        std::string s;
        std::cin >> op >> s;
        if (op == 1) {
            std::cout << (trie.contains(s) ? "Yes" : "No") << '\n';
        } else if (op == 2) {
            std::cout << trie.count_prefix(s) << '\n';
        }
    }
}
class Trie:
    """节点 0 为根;字典只保存实际存在的字符边。"""

    def __init__(self) -> None:
        self.ch: list[dict[str, int]] = [{}]
        self.pass_count: list[int] = [0]
        self.end: list[int] = [0]

    def insert(self, s: str) -> None:
        u = 0
        self.pass_count[u] += 1
        for c in s:
            v = self.ch[u].get(c)
            if v is None:
                v = len(self.ch)
                self.ch[u][c] = v
                self.ch.append({})
                self.pass_count.append(0)
                self.end.append(0)
            u = v
            self.pass_count[u] += 1
        self.end[u] += 1

    def find(self, s: str) -> int:
        """返回字符串对应节点;路径不存在时返回 -1。"""
        u = 0
        for c in s:
            v = self.ch[u].get(c)
            if v is None:
                return -1
            u = v
        return u

    def contains(self, s: str) -> bool:
        u = self.find(s)
        return u != -1 and self.end[u] > 0

    def count_prefix(self, prefix: str) -> int:
        u = self.find(prefix)
        return 0 if u == -1 else self.pass_count[u]


def main() -> None:
    import sys

    data = iter(sys.stdin.buffer.read().split())
    first = next(data, None)
    if first is None:
        return
    n, q = int(first), int(next(data))
    trie = Trie()
    for _ in range(n):
        trie.insert(next(data).decode())

    out: list[str] = []
    for _ in range(q):
        op = int(next(data))
        s = next(data).decode()
        if op == 1:
            out.append("Yes" if trie.contains(s) else "No")
        elif op == 2:
            out.append(str(trie.count_prefix(s)))
    if out:
        sys.stdout.write("\n".join(out) + "\n")


if __name__ == "__main__":
    main()
输入:
5 7
app
apple
apply
apt
bat
1 app
1 ap
2 app
2 ap
2 ba
1 bat
2 cat
输出:
Yes
No
3
4
1
Yes
0
其中 ap 的路径存在,却不是完整字符串;前缀 ap 对应 app、apple、apply、apt,所以计数为
8 时间与空间复杂度
设单次操作的字符串长度为
| 操作 | 固定孩子数组 | 字典存孩子 |
|---|---|---|
| 插入 | 新建节点时初始化孩子数组,摊还 |
期望摊还 |
| 完整字符串查询 | 期望 |
|
| 前缀计数 | 期望 |
本文 C++ 的 vector 扩容的代价按多次插入摊还计算。查询的时间不再随已插入字符串的数量线性增长。
每插入一个字符,最多创建一个节点,所以节点数至多为
如果只判断完整字符串是否出现,哈希集合通常更简洁。Trie 的优势在于同一个结构还可以处理前缀计数、沿字符逐位选择,以及按字符顺序遍历。
9 从基本 Trie 继续扩展
9.1 集合查询与重复访问标记
先把字典中的单词插入,再对询问串检查 end。如果题目还要求区分「第一次询问」与「重复询问」,需要在终止节点另加访问标记;它与表示插入次数的 end 是两件事。
9.2 前缀统计与字典序
前缀计数直接使用 pass。若需要按字典序输出字符串,可以从根开始,按字符从小到大的顺序遍历孩子;到达 end > 0 的节点时先输出当前字符串,再继续访问孩子,因为一个字符串排在它的真扩展之前,例如 app 排在 apple 前面。
9.3 最长公共前缀与最近公共祖先
把两个字符串对应的节点记为
例如 apple 与 apply 对应节点 appl,长度为 app 与 apple 中,前者本身就是后者的前缀,所以 LCA 正是表示 app 的节点。
如果题目要对许多字符串反复查询最长公共前缀,可以考虑在建好 Trie 后预处理 LCA;只有少量查询时,直接逐字符比较更简单。
9.4 01-Trie 与异或最值
把非负整数写成固定长度的二进制串,字符集就只有
9.5 AC 自动机的基础
如果有许多模式串,需要一起在长文本中匹配,先用 Trie 保存这些模式串,再增加失配指针,就得到 AC 自动机的基础结构。Trie 的基本查询从根匹配一个字符串;多模式匹配还需要处理文本扫描时的失配跳转。
10 推荐练习
- luogu P2580: 于是他错误的点名开始了:完整字符串查询,并额外记录是否已被点名。
- luogu P4551: 最长异或路径:进阶,把树上路径异或转为两个根路径异或,再使用 01-Trie。
- luogu P3808: AC 自动机(简单版):进阶,在 Trie 基础上学习多模式串匹配。
11 相关题解
暂无相关题解