先把每个点向上
阅读前建议先掌握 树的入门(树的存储与遍历)、DFS序(深度与子树区间)和 binary jump(倍增思想)。
1 问题模型
给定一棵有根树,需要反复回答:两个点
树必须先选定根。根不同,祖先关系也可能不同,所以题目给了根
最近公共祖先(Lowest Common Ancestor,LCA):在有根树中,
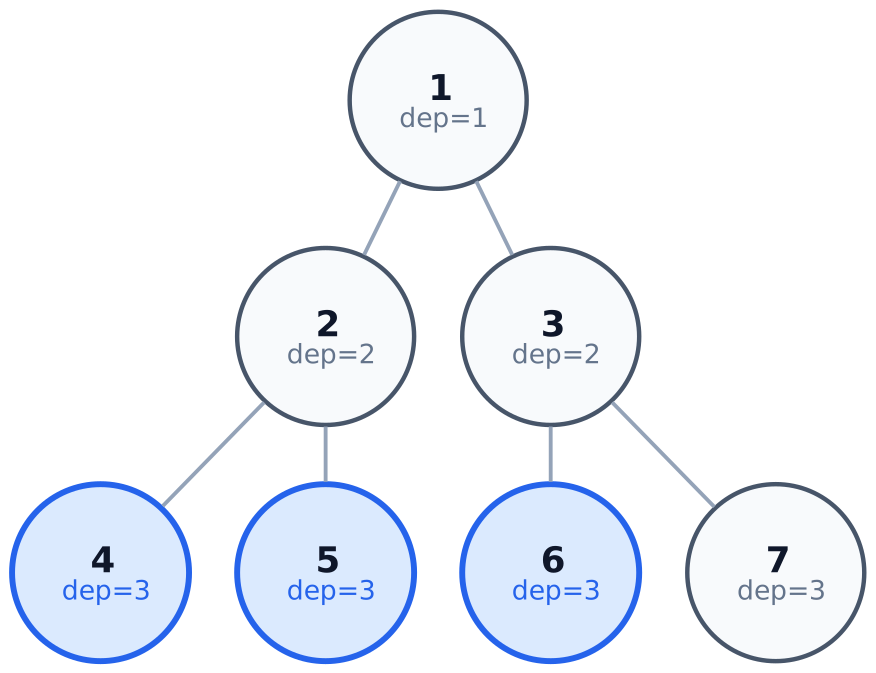
用上面这棵样例树对照:
| 查询 | LCA | 属于哪种情形 |
|---|---|---|
| 两点的 LCA 在中间层,谁都不是谁的祖先 | ||
| 两点分居根的两个不同子树 | ||
| 一个点本身就是另一个点的祖先 | ||
| 同上,浅点是答案 |
LCA 是所有“树上路径”问题的基础:知道
2 核心直觉:为什么可以“一次跳很多层”
最笨的求法是:让两个点一步一步往上爬,直到相遇。链形树上单次询问就是
爬树法(也就是倍增法在树上的用法)注意到:上跳的距离可以任意拆分,只要把它拆成若干个
于是预处理一张表
需要上跳
这张表的精髓是它自己可以递推:跳
所以只要知道每个点的父亲(
3 算法步骤
一、 预处理:一次 DFS 填满两张表
从根开始 DFS,进入点
- 记下深度
dep[u]与父亲up[u][0]; - 用递推式把
up[u][1..lg]整行拼出来。
因为走到
根的父节点指向哨兵点 0,约定 dep[0]=0、up[0][*]=0。这样任何越界的上跳都会落进这个“黑洞点”,查询时不需要再判断祖先是否存在。
倍增层数 lg 取 floor(log2(n))。因为任何上跳距离都不超过 lg,所以这一层数足够;若写成固定常量(例如 MAXLOG = 17),必须保证
二、 第 k 祖先:把 k 拆成二进制
求
int kth_ancestor(int u, int k) {
    for (int j = 0; j <= lg && u; ++j)
        if (k >> j & 1) u = up[u][j];
    return u;
}
这一步是 LCA 查询“把深点提到同一层”的子程序,本身也常被单独考(第
三、 查询 LCA:先对齐,再一起跳
查询
- 对齐:若
比 浅就交换,保证 更深;然后让 上跳 层,两点同深。 - 同点直接返回:此时若
,说明浅点就是 LCA。 - 一起跳:
从大到小枚举,如果 就同时跳;相等说明这一步会到达或越过 LCA,不能跳。循环结束时两点停在 LCA 的两个不同儿子上,答案是 。
第 3 步为什么“不相等才跳”是关键:我们始终让两个点保持不同。一旦祖先相同,说明这个位置已经是公共祖先,可能正好是 LCA,也可能在 LCA 之上;此时不能确定,就不跳。等所有
4 算法证明
P1: 对齐不会越过 LCA
设
P2: 对齐后
同深且
P3: 从大到小同时跳不会越过 LCA
设
对任意
P4: 循环结束时两点是
对齐后两点同深,且循环中每次都同时上跳,所以循环结束时两点仍同深,记为
反设
即
故
5 复杂度分析
设树有
- 预处理:一次 DFS 访问
个点,每点填 个祖先,时间 ,空间 ; - 单次查询:对齐
,同时上跳 ,合计 ; - 总时间
。
up 表是 int,约 7MB,通常可以接受。
6 代码模板
两份模板的接口保持一致,都是全局数组 + 自由函数,不使用 struct 或 class,可以整段复制进题解。编号 0。唯一差别是 Python 需要先 init(n) 分配列表,C++ 用定长全局数组所以没有这一步。
| 接口 | 用途 |
|---|---|
init(n)(仅 Python) |
先按 |
add_edge(u, v) |
添加无向边, |
build(n, root) |
加完边后调用一次:按 lg,再 DFS 填 dep 与 up |
lca(u, v) |
求最近公共祖先, |
kth_ancestor(u, k) |
求 0 |
dist(u, v) |
两点间边数, |
两份模板都把“深度 + 祖先表”的填充放在同一次 DFS 里,所以预处理只有一个入口 build。C++ 用定长全局数组,多组数据时只需清一下邻接表;Python 按 init(n) 即可,没有 MAXLOG 这类常量限制。
#include <bits/stdc++.h>
using namespace std;

// 倍增(爬树)法求 LCA:全局数组 + 自由函数,不含 main,可整段复制进题解。
//
// 用法:
//   1. add_edge(u, v);           // 加边,n-1 条边都要加完
//   2. build(n, root);           // 一次 DFS 算出 dep 与整张 up 表
//   3. lca(u, v) / kth_ancestor(u, k) / dist(u, v)
//
// 编号 1..n;根的父亲是哨兵 0,dep[0] = 0,up[0][*] 恒为 0,
// 任何越界的上跳都落在这个黑洞点里,不需要额外判空。
// 递归深度最坏是 n(链形树),n 很大时要开大栈(ulimit -s unlimited)。

const int maxn = 1e5 + 5;
const int MAXLOG = 17; // 必须满足 2^MAXLOG >= n;maxn = 1e5 时 17 够用

vector<int> g[maxn];
int dep[maxn];              // dep[u]:深度,根为 1
int up[maxn][MAXLOG + 1];   // up[u][j]:u 的 2^j 级祖先
int lg;                     // 实际用到的最大指数,由 n 算出

void add_edge(int u, int v) {
    g[u].push_back(v);
    g[v].push_back(u);
}

// 进入 u 时它的整行 up 就能拼出来:up[u][j] = up[ up[u][j-1] ][j-1],
// 所以不需要先 DFS 一遍再单独跑一轮倍增 DP。
void dfs(int u, int fa) {
    dep[u] = dep[fa] + 1;
    up[u][0] = fa;
    for (int j = 1; j <= lg; ++j) up[u][j] = up[up[u][j - 1]][j - 1];
    for (int v : g[u]) {
        if (v == fa) continue;
        dfs(v, u);
    }
}

// 预处理入口:加完边之后调用一次。数组在 dfs 里逐点覆写,无需 memset。
void build(int n, int root) {
    lg = 0;
    while (lg < MAXLOG && (1 << (lg + 1)) <= n) ++lg; // lg = floor(log2(n))
    dfs(root, 0);
}

// u 向上跳 k 层;k 超过深度时返回 0
int kth_ancestor(int u, int k) {
    for (int j = 0; j <= lg && u; ++j)
        if (k >> j & 1) u = up[u][j];
    return u;
}

int lca(int u, int v) {
    if (dep[u] < dep[v]) swap(u, v);
    u = kth_ancestor(u, dep[u] - dep[v]); // 第一步:深的点先提到同一层
    if (u == v) return u;                 // 浅点本身就是答案
    for (int j = lg; j >= 0; --j)         // 第二步:从大步到小步一起上跳
        if (up[u][j] != up[v][j]) {
            u = up[u][j];
            v = up[v][j];
        }
    return up[u][0]; // 停在 LCA 的两个不同儿子上,再上一层就是答案
}

int dist(int u, int v) {
    int w = lca(u, v);
    return dep[u] + dep[v] - 2 * dep[w];
}
# 倍增(爬树)法求 LCA:全局数组 + 自由函数,不含 main,可整段复制进题解。
#
# 用法:
#   1. init(n)                 # 按 n 分配邻接表与祖先表(多组数据时重调即可)
#   2. add_edge(u, v)          # 加边,n-1 条边都要加完
#   3. build(n, root)          # 一次 DFS 算出 dep 与整张 up 表
#   4. lca(u, v) / kth_ancestor(u, k) / dist(u, v)
#
# 编号 1..n;根的父亲是哨兵 0,dep[0] = 0,up[0][*] 恒为 0,
# 任何越界的上跳都落在这个黑洞点里,不需要额外判空。
# Python 的递归同样受深度限制,init() 里会按 n 放宽递归上限。

g = []
dep = []
up = []
lg = 0


def init(n):
    """一组新数据:重建邻接表与两张表,并按 n 放宽递归上限。"""
    global g, dep, up, lg
    import sys
    if sys.getrecursionlimit() < 3 * n + 100:
        sys.setrecursionlimit(3 * n + 100)
    lg = 0
    while (1 << (lg + 1)) <= n:
        lg += 1
    g = [[] for _ in range(n + 1)]
    dep = [0] * (n + 1)
    up = [[0] * (lg + 1) for _ in range(n + 1)]


def add_edge(u, v):
    g[u].append(v)
    g[v].append(u)


def dfs(u, fa):
    """进入 u 时它的整行 up 就能拼出来:up[u][j] = up[up[u][j-1]][j-1]。"""
    dep[u] = dep[fa] + 1
    up[u][0] = fa
    for j in range(1, lg + 1):
        up[u][j] = up[up[u][j - 1]][j - 1]
    for v in g[u]:
        if v == fa:
            continue
        dfs(v, u)


def build(n, root):
    """预处理入口:先 init(n) 分好数组、加完边之后调用一次。"""
    dfs(root, 0)


def kth_ancestor(u, k):
    """u 向上跳 k 层;k 超过深度时返回 0。"""
    j = 0
    while j <= lg and u:
        if k >> j & 1:
            u = up[u][j]
        j += 1
    return u


def lca(u, v):
    if dep[u] < dep[v]:
        u, v = v, u
    u = kth_ancestor(u, dep[u] - dep[v])  # 第一步:深的点先提到同一层
    if u == v:                            # 浅点本身就是答案
        return u
    for j in range(lg, -1, -1):           # 第二步:从大步到小步一起上跳
        if up[u][j] != up[v][j]:
            u = up[u][j]
            v = up[v][j]
    return up[u][0]  # 停在 LCA 的两个不同儿子上,再上一层就是答案


def dist(u, v):
    w = lca(u, v)
    return dep[u] + dep[v] - 2 * dep[w]
7 完整代码
输入格式(即 luogu P3379: 【模板】最近公共祖先(LCA) 的格式):第一行 n m root,随后
#include <bits/stdc++.h>
using namespace std;

// 倍增(爬树)法求 LCA:全局数组 + 自由函数,不含 main,可整段复制进题解。
//
// 用法:
//   1. add_edge(u, v);           // 加边,n-1 条边都要加完
//   2. build(n, root);           // 一次 DFS 算出 dep 与整张 up 表
//   3. lca(u, v) / kth_ancestor(u, k) / dist(u, v)
//
// 编号 1..n;根的父亲是哨兵 0,dep[0] = 0,up[0][*] 恒为 0,
// 任何越界的上跳都落在这个黑洞点里,不需要额外判空。
// 递归深度最坏是 n(链形树),n 很大时要开大栈(ulimit -s unlimited)。

const int maxn = 1e5 + 5;
const int MAXLOG = 17; // 必须满足 2^MAXLOG >= n;maxn = 1e5 时 17 够用

vector<int> g[maxn];
int dep[maxn];              // dep[u]:深度,根为 1
int up[maxn][MAXLOG + 1];   // up[u][j]:u 的 2^j 级祖先
int lg;                     // 实际用到的最大指数,由 n 算出

void add_edge(int u, int v) {
    g[u].push_back(v);
    g[v].push_back(u);
}

// 进入 u 时它的整行 up 就能拼出来:up[u][j] = up[ up[u][j-1] ][j-1],
// 所以不需要先 DFS 一遍再单独跑一轮倍增 DP。
void dfs(int u, int fa) {
    dep[u] = dep[fa] + 1;
    up[u][0] = fa;
    for (int j = 1; j <= lg; ++j) up[u][j] = up[up[u][j - 1]][j - 1];
    for (int v : g[u]) {
        if (v == fa) continue;
        dfs(v, u);
    }
}

// 预处理入口:加完边之后调用一次。数组在 dfs 里逐点覆写,无需 memset。
void build(int n, int root) {
    lg = 0;
    while (lg < MAXLOG && (1 << (lg + 1)) <= n) ++lg; // lg = floor(log2(n))
    dfs(root, 0);
}

// u 向上跳 k 层;k 超过深度时返回 0
int kth_ancestor(int u, int k) {
    for (int j = 0; j <= lg && u; ++j)
        if (k >> j & 1) u = up[u][j];
    return u;
}

int lca(int u, int v) {
    if (dep[u] < dep[v]) swap(u, v);
    u = kth_ancestor(u, dep[u] - dep[v]); // 第一步:深的点先提到同一层
    if (u == v) return u;                 // 浅点本身就是答案
    for (int j = lg; j >= 0; --j)         // 第二步:从大步到小步一起上跳
        if (up[u][j] != up[v][j]) {
            u = up[u][j];
            v = up[v][j];
        }
    return up[u][0]; // 停在 LCA 的两个不同儿子上,再上一层就是答案
}

int dist(int u, int v) {
    int w = lca(u, v);
    return dep[u] + dep[v] - 2 * dep[w];
}

/*------------------------ 读入输出 ------------------------*/

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m, root;
    cin >> n >> m >> root;

    for (int i = 1; i < n; ++i) {
        int u, v;
        cin >> u >> v;
        add_edge(u, v);
    }

    build(n, root);

    while (m--) {
        int u, v;
        cin >> u >> v;
        cout << lca(u, v) << '\n';
    }

    return 0;
}
# 倍增(爬树)法求 LCA:全局数组 + 自由函数,不含 main,可整段复制进题解。
#
# 用法:
#   1. add_edge(u, v)          # 加边,n-1 条边都要加完
#   2. build(n, root)          # 一次 DFS 算出 dep 与整张 up 表
#   3. lca(u, v) / kth_ancestor(u, k) / dist(u, v)
#
# 编号 1..n;根的父亲是哨兵 0,dep[0] = 0,up[0][*] 恒为 0,
# 任何越界的上跳都落在这个黑洞点里,不需要额外判空。
# Python 的递归同样受深度限制,init() 里会按 n 放宽递归上限。

g = []
dep = []
up = []
lg = 0


def init(n):
    """一组新数据:重建邻接表与两张表,并按 n 放宽递归上限。"""
    global g, dep, up, lg
    import sys
    if sys.getrecursionlimit() < 3 * n + 100:
        sys.setrecursionlimit(3 * n + 100)
    lg = 0
    while (1 << (lg + 1)) <= n:
        lg += 1
    g = [[] for _ in range(n + 1)]
    dep = [0] * (n + 1)
    up = [[0] * (lg + 1) for _ in range(n + 1)]


def add_edge(u, v):
    g[u].append(v)
    g[v].append(u)


def dfs(u, fa):
    """进入 u 时它的整行 up 就能拼出来:up[u][j] = up[up[u][j-1]][j-1]。"""
    dep[u] = dep[fa] + 1
    up[u][0] = fa
    for j in range(1, lg + 1):
        up[u][j] = up[up[u][j - 1]][j - 1]
    for v in g[u]:
        if v == fa:
            continue
        dfs(v, u)


def build(n, root):
    """预处理入口:加完边之后调用一次。"""
    init(n)
    dfs(root, 0)


def kth_ancestor(u, k):
    """u 向上跳 k 层;k 超过深度时返回 0。"""
    j = 0
    while j <= lg and u:
        if k >> j & 1:
            u = up[u][j]
        j += 1
    return u


def lca(u, v):
    if dep[u] < dep[v]:
        u, v = v, u
    u = kth_ancestor(u, dep[u] - dep[v])  # 第一步:深的点先提到同一层
    if u == v:                            # 浅点本身就是答案
        return u
    for j in range(lg, -1, -1):           # 第二步:从大步到小步一起上跳
        if up[u][j] != up[v][j]:
            u = up[u][j]
            v = up[v][j]
    return up[u][0]  # 停在 LCA 的两个不同儿子上,再上一层就是答案


def dist(u, v):
    w = lca(u, v)
    return dep[u] + dep[v] - 2 * dep[w]


# ------------------------ 读入输出 ------------------------

def main():
    import sys
    read = sys.stdin.buffer.readline
    n, m, root = map(int, read().split())
    init(n)
    for _ in range(n - 1):
        u, v = map(int, read().split())
        add_edge(u, v)
    dfs(root, 0)

    out = []
    for _ in range(m):
        u, v = map(int, read().split())
        out.append(str(lca(u, v)))
    sys.stdout.write("\n".join(out))


if __name__ == "__main__":
    main()
8 测试用例
用本节开头那棵样例树(根为
7 6 1
1 2
1 3
2 4
2 5
3 6
3 7
4 5
4 6
3 7
4 2
1 7
2 3
输出:
2
1
3
2
1
1
对照前面那张表:
换根也值得试一次。下面这棵是链,根取中间的点
8 3 5
1 2
2 3
3 4
4 5
5 6
6 7
7 8
1 8
5 5
6 7
输出为 5、5、6。第一个查询说明根在链中间时,两端点的 LCA 就是根自己;5 5 说明 6 7 说明一个点是另一个点的祖先时返回浅点。
9 易错点
lg不够大:lg取floor(log2(n));写成固定常量时必须满足,否则大的上跳会被悄悄截断。 - 根用错:题目给了根就从它 DFS。若把根固定成
,而题目实际以别的点为根,整张祖先表都是错的。 - 忘记对齐后的同点判断:少写
if (u == v) return u;,会在“一个点是另一个点的祖先”时返回0或死循环。 - 比较
up[u][j]的方向反了:写成“相等才跳”会把两个点直接顶到根上。 - 根的父节点处理不一致:模板统一用哨兵
0,且dep[0]=0、up[0][*]=0。若改成“根的父亲是根自己”,则必须同时保证不会在up[0]上越界。 - 递归爆栈:链形树深度可达
, 时 C++ 要开大栈( ulimit -s unlimited),Python 模板已在init里调高sys.setrecursionlimit。 - 多组数据忘记清空:C++ 的
up表会被 DFS 逐点覆写,但邻接表g[]必须自己clear();Python 重调一次init(n)即可。
10 扩展:一次上跳顺便维护路径信息
很多题不只问 LCA,还要问路径上的最大边、最小边、边权和。做法是在 up[u][j] 旁边维护一张同样大小的表,合并方式与 up 完全一样——因为“跳
例如维护向上跳
查询时仍然“先对齐、再同时跳”,只在真正发生跳跃的地方把对应信息并进答案。
| 维护信息 | 含义 | 典型用途 |
|---|---|---|
mx[u][j] |
向上 |
货车运输、瓶颈路 |
mn[u][j] |
向上 |
路径瓶颈最小值 |
sum[u][j] |
向上 |
路径长度、费用 |
维护边权时,节点跳到 LCA 后不要把 LCA 的父边算进去。通常只在实际发生上跳时合并这一段的信息;对齐阶段也要注意,最后落到 LCA 时那一步没有跨过新的边。
另一个常见扩展是判断祖先关系。用 LCA 的写法是 in[u] <= in[v] && out[v] <= out[u]。
11 和其它 LCA 求法的对比
| 方法 | 预处理 | 单次查询 | 适用场景 |
|---|---|---|---|
| 倍增(爬树)法 | 在线查询,容易扩展路径信息 | ||
| 欧拉序 + RMQ | 静态树、只问 LCA | ||
| Tarjan 离线 | 近似 |
离线统一处理 | 所有询问可以提前读完 |
| 树链剖分 | 同时要做路径修改与路径查询 |
如果只问 LCA,爬树法足够稳定、代码最短;如果要路径加 / 路径和这类复合操作,改用 树链剖分(HLD)。
12 练习题目
- luogu P3379: 【模板】最近公共祖先(LCA):倍增 LCA 标准模板题,本文完整代码可直接提交。
- luogu P5836: [USACO19DEC] Milk Visits S:同样的查询,用 Tarjan 离线做,可与本文对拍。
- luogu P5903: 【模板】树上 K 级祖先:直接练
kth_ancestor,把拆成二进制位向上跳。 - luogu P3258: [JLOI2014] 松鼠的新家:按访问顺序把每段路径整体加一,用 LCA + 树上差分。
- luogu P3128: [USACO15DEC] Max Flow P:点差分模板题,统计每条路径的覆盖次数。
- luogu P1967: [NOIP 2013 提高组] 货车运输:先建最大生成树,再用 LCA 倍增维护路径最小边权。
- luogu P4180: [BJWC2010] 严格次小生成树:枚举非树边,用 LCA 倍增查询路径最大边与严格次大边。
- luogu P4281: [AHOI2008] 紧急集合 / 聚会:一次查询三个点,答案与它们两两 LCA 中深度最大的两个有关。
13 参考
- 树的存储与遍历:树的入门;
- 深度、子树区间与祖孙判定:DFS序;
- 倍增思想的通用形式:binary jump;
- 把路径拆成区间做区间操作:树链剖分(HLD);
- 树上差分:树上差分。
14 相关题解
暂无相关题解