算法背景与问题模型
前置算法: [[dijkstra]]。
在经典的单源最短路问题中,我们只关心从源点
次短路通常分为两种定义:
- 严格次短路:路径长度必须严格大于最短路径长度(即
)。 - 非严格次短路:允许与最短路径长度相等(即第二条候选路径的长度,允许
)。
本文重点讲解在非负权图上求解严格次短路的标准 Dijkstra 算法。
核心思维:状态拆分与动态规划转移
在普通 Dijkstra 中,每个节点
而在次短路问题中,点
:从源点 到点 的最短路径长度; :从源点 到点 的严格次短路径长度。
松弛操作的三种情况
当从堆中弹出一个状态
此时对目标点
-
情况 1:
(打破最短路) - 发现了比当前最短路还要短的走法!
- 原来的最短路
降级成为次短路: - 新距离成为新的最短路:
- 将
和 都压入优先队列中。
-
情况 2:
(打破次短路) - 虽然无法超越最短路,但比当前的次短路更优(且严格大于最短路)!
- 更新次短路:
- 将
压入优先队列中。
-
情况 3:
或 - 无法对严格次短路带来任何改进,直接忽略。
图解次短路求解过程
以下图为例(源点为
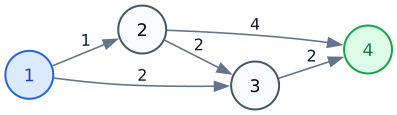
边权说明:
权值 权值 权值 权值 权值
交互式动画演练
下面是使用优先队列求解次短路的动态模拟过程:
交互动画加载中...
状态演进步骤表
| 轮次 | 弹出状态 (d, u) |
状态性质 | 考察出边 | 松弛目标点与结果 |
|---|---|---|---|---|
| 初始 | - | - | - | [(0, 1)] |
| 1 | (0, 1) | 点 1 最短路 | 更新 |
|
| 2 | (1, 2) | 点 2 最短路 | ||
| 3 | (2, 3) | 点 3 最短路 | 原最短路降级: 新最短路产生: |
|
| 4 | (3, 3) | 点 3 次短路 | ||
| 5 | (4, 4) | 点 4 最短路 | 无出边 | 最短路确定为 |
| 6 | (5, 4) | 点 4 次短路 | 无出边 | 次短路确定为 |
最终得出点
- 最短路:
(路径 ) - 严格次短路:
(路径 )
算法核心过程
- 初始化:
- 距离数组:
,其余所有点的 与全部点的 均初始化为 。 - 小根堆压入初始状态
。
- 距离数组:
- 循环直到小根堆为空:
- 弹出堆顶最小距离状态
。 - 过期剪枝:若
,说明该状态比当前已知的次短路还要差,直接跳过。 - 枚举节点
的所有出边 ,令 : - 若
:更新 并入堆;再更新 并入堆。 - 若
:更新 并入堆。
- 若
- 弹出堆顶最小距离状态
模板代码
#include <algorithm>
#include <functional>
#include <iostream>
#include <queue>
#include <utility>
#include <vector>

struct SecondShortestDijkstra {
    using ll = long long;
    static constexpr ll INF = (1LL << 62);

    struct Edge {
        int to;
        ll w;
    };

    int n;
    std::vector<std::vector<Edge>> g;
    std::vector<ll> dis1; // 最短距离
    std::vector<ll> dis2; // 严格次短距离

    explicit SecondShortestDijkstra(int n)
        : n(n), g(n + 1), dis1(n + 1, INF), dis2(n + 1, INF) {}

    void add_edge(int u, int v, ll w) {
        g[u].push_back({v, w});
    }

    void add_undirected_edge(int u, int v, ll w) {
        add_edge(u, v, w);
        add_edge(v, u, w);
    }

    void run(int s) {
        std::fill(dis1.begin(), dis1.end(), INF);
        std::fill(dis2.begin(), dis2.end(), INF);

        // State: (当前候选距离, 目标点)
        using State = std::pair<ll, int>;
        std::priority_queue<State, std::vector<State>, std::greater<State>> q;

        dis1[s] = 0;
        q.push({0, s});

        while (!q.empty()) {
            auto [d, u] = q.top();
            q.pop();

            // 如果当前距离比已记录的次短路还要大,则没有任何利用价值,直接跳过
            if (d > dis2[u]) continue;

            for (const auto& e : g[u]) {
                int v = e.to;
                ll nd = d + e.w;

                // 1. 尝试松弛最短路
                if (nd < dis1[v]) {
                    // 原来的最短路降级为次短路
                    dis2[v] = dis1[v];
                    q.push({dis2[v], v});

                    dis1[v] = nd;
                    q.push({dis1[v], v});
                }
                // 2. 无法更新最短路,尝试更新严格次短路
                // 要求 nd 严格大于最短路 dis1[v],且严格小于当前次短路 dis2[v]
                else if (nd > dis1[v] && nd < dis2[v]) {
                    dis2[v] = nd;
                    q.push({dis2[v], v});
                }
            }
        }
    }
};
深刻思考:它退化成 SPFA 了吗?(不动点与状态升维)
一个非常自然且深刻的疑问:
“去掉每个点只能访问一次的限制后,节点距离一变小就重新入堆通知邻居,这难道不是退化成了 SPFA 的‘松弛到不动点’吗?它和动态规划在图上的‘反复转移直到收敛’是一回事吗?”
从值迭代(Value Iteration)与不动点收敛的角度看,最短路与次短路的贝尔曼方程本质上确实是 DP 在图上的松弛求解;如果没有贪心约束,任意反复通知后继确实就是 SPFA 的形态。
但本算法并没有退化成 SPFA,它依然严格守住了 Dijkstra 的贪心界限!
- 不是扔掉 visited,而是将状态升维:
- SPFA 中一个节点最坏可能被更新入队
甚至指数次; - 而在这里,每个物理点
被逻辑拆分为两个独立状态: 与 ,全图只有 个确定状态。 - 相当于将
visited[u]变成了visit_count[u] <= 2。
- SPFA 中一个节点最坏可能被更新入队
- 小根堆依然保证“出堆即确定”:
- 第一次有效出堆必是最终最短路;第二次有效出堆必是最终次短路;
- 第三次及以后的劣质更新直接被
d > dis2[u]永久剪枝丢弃,永不反悔。
因此,它巧妙利用优先队列将原本可能反复震荡的“不动点收敛”,严格锁死在 2 倍常数的 Dijkstra 复杂度之内。
复杂度分析
设图的顶点数为
- 每个顶点最多产生两次有效扩展(一次作为最短路出堆,一次作为次短路出堆);
- 优先队列中最多同时容纳的状态数量为
级别; - 堆操作的时间复杂度为
; - 总时间复杂度为
,与标准 Dijkstra 保持在同一数量级!
相关前置章节:
[[dijkstra]]:基础单源最短路与堆优化[[bellman-ford]]:负权图与边数判定基础